Mon premier OPNsense fonctionnait très bien. C’était justement le problème.
Tout le cœur du réseau reposait sur fw-core-p1 : le LAN, huit VLANs, l’accès Internet et les routes entre mes différentes zones. Tant que la VM tournait, je n’avais aucune raison d’y penser. Dès qu’une mise à jour demandait un redémarrage, la question revenait : qu’est-ce qui reste accessible si ce firewall s’arrête ?
Pas grand-chose.
Je ne cherchais pas à transformer mon homelab en infrastructure bancaire. Je voulais simplement pouvoir maintenir un firewall sans couper volontairement tout ce qui passait derrière lui. C’est comme ça que fw-core-p2 est arrivé.
Une seconde VM ne fait pas encore un cluster
Le plus facile aurait été de cloner fw-core-p1, de démarrer la copie et d’appeler ça de la haute disponibilité. Deux firewalls mal coordonnés savent surtout produire deux fois plus de problèmes.
J’ai donc commencé par leur donner la même forme. Les deux VM vivent sur deux nœuds Proxmox différents et possèdent exactement le même ordre d’interfaces : le WAN, le LAN, les huit VLANs du homelab, puis une dernière interface réservée à la synchronisation.
| |
Cette symétrie n’est pas seulement jolie dans Terraform. pfsync associe les états aux interfaces : si leur ordre ou leur nom diffère entre les deux machines, la réplication ne raconte plus la même histoire des deux côtés.
CARP, pfsync et XML-RPC ne font pas le même travail
J’avais tendance à ranger tout cela dans la boîte « HA ». En pratique, trois mécanismes distincts coopèrent.
CARP (Common Address Redundancy Protocol) détermine quel firewall porte les adresses IP virtuelles. Les machines du réseau utilisent ces VIP comme passerelles et n’ont pas besoin de savoir si p1 ou p2 répond derrière.
pfsync réplique la table d’états. Quand p2 reprend le trafic, il connaît déjà les connexions suivies par p1 au lieu de repartir avec une feuille blanche.
XML-RPC synchronise la configuration depuis le primaire : règles, alias, NAT et objets partagés. Le second nœud reste ainsi un vrai pair, pas une vieille copie que j’espère encore correcte six mois plus tard.
La documentation HA d’OPNsense recommande justement une interface dédiée à pfsync. J’ai appliqué ce principe avec le VLAN 999, utilisé également pour la synchronisation de configuration.
Dans Terraform, ce choix tient dans quelques lignes :
| |
Ce petit vtnet10 est pourtant l’une des pièces les plus importantes du montage. Le trafic utilisateur et les échanges qui permettent au cluster de rester cohérent ne se disputent pas la même interface logique.
Le moment où neuf VIP ont changé de côté
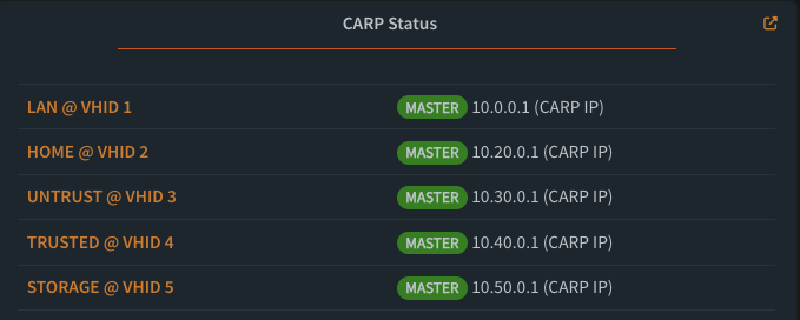
Une interface verte dans OPNsense ne prouve pas grand-chose. Le cluster est devenu réel le jour où j’ai placé fw-core-p1 en maintenance et regardé fw-core-p2 reprendre les neuf VIP.
| |
Le DNS continuait de répondre et mes routes applicatives restaient accessibles. En quittant le mode maintenance, p1 a repris son rôle par préemption et p2 est retourné attendre en secours.
C’est un test très simple, mais il change complètement la confiance que j’accorde au montage. Avant lui, j’avais deux VM configurées pour faire du CARP. Après lui, j’avais un cluster que je pouvais réellement utiliser pendant une intervention.
La haute disponibilité synchronise aussi les erreurs
Le piège le plus intéressant est arrivé plus tard. Une VIP utilisait un pair CARP unicast propre à p1. XML-RPC a parfaitement synchronisé cette valeur vers p2, qui s’est alors mis à envoyer ses annonces… à sa propre adresse.
La synchronisation n’était pas cassée. Elle exécutait fidèlement une configuration qui n’aurait pas dû être identique sur les deux nœuds.
J’ai raconté cette petite surprise dans ma révision du cluster OPNsense. Elle m’a rappelé qu’un cluster ne rend pas une configuration correcte par magie. Il propage aussi très efficacement les mauvaises idées.
Le retour au multicast CARP a supprimé cette exception locale et rendu les deux configurations réellement partageables. Depuis, mon test ne consiste plus seulement à vérifier que les deux firewalls affichent du vert : je provoque la bascule et je contrôle ce qui continue à fonctionner.
Ce que ce second firewall a réellement changé
Je n’ai pas supprimé tous les points de panne. Les deux VM dépendent toujours du réseau physique, des bridges Proxmox et de ce qui se trouve en amont. La haute disponibilité du firewall ne rend pas magiquement le reste du homelab redondant.
Elle a en revanche retiré un blocage très concret : je peux éteindre un OPNsense sans considérer la coupure comme une étape normale de la maintenance.
Le bénéfice n’est pas spectaculaire quand tout va bien. fw-core-p2 passe l’essentiel de son temps en BACKUP, ce qui est exactement ce que je lui demande. Sa valeur apparaît quand je mets à jour p1, quand je redémarre une VM ou quand je veux vérifier une modification sans jouer toute la connectivité du homelab sur un seul clic.
Au fond, j’ai doublé mon firewall pour pouvoir enfin en éteindre un sereinement. C’était tout le projet.