Une interface réseau disparaît à la fin d’un job. La mémoire du runner grimpe pendant un build. Une sonde mail dépasse son délai une seule fois. Un disque rappelle toutes les quelques minutes qu’il est toujours plein.
Pris séparément, chacun de ces événements mérite d’être observé. Transformés avec la même urgence en notifications, ils finissent surtout par m’apprendre à ne plus les regarder.
C’est le piège classique de la supervision : au début, on veut tout voir. Puis on ajoute des contrôles, des machines et des seuils jusqu’au moment où le système fonctionne techniquement, mais où le signal utile se retrouve noyé dans le bruit.
J’ai donc repris mes règles Checkmk une par une. Mon objectif n’était pas d’obtenir un joli écran entièrement vert. Je voulais qu’une notification signifie de nouveau : « il faut regarder maintenant ».
Le bruit n’a pas une cause unique
La mauvaise solution aurait été de relever tous les seuils ou de désactiver les services pénibles. C’est tentant, rapide et particulièrement efficace pour fabriquer une fausse tranquillité.
À la place, j’ai classé chaque alerte dans l’une de ces familles :
| Situation | Exemple dans mon homelab | Réponse |
|---|---|---|
| état attendu | interface TAP supprimée avec une VM éphémère | ignorer précisément ce service |
| incident transitoire | pic de mémoire pendant un job CI | demander une seconde confirmation |
| problème réel mais répétitif | disque toujours en alerte | conserver l’état, espacer les notifications |
| seuil mal adapté | résolution DNS correcte mais un peu variable | recalibrer avec une mesure cohérente |
Cette distinction paraît évidente après coup. Dans la pratique, elle oblige à répondre à une question parfois inconfortable : qu’est-ce qui justifie réellement de m’interrompre ?
Les interfaces TAP : du bruit parfaitement normal
Mes nœuds Proxmox créent des interfaces TAP pour connecter les interfaces réseau virtuelles des VM. Leur nom suit une forme comme :
| |
Ces interfaces vivent aussi longtemps que la VM ou la charge CI correspondante. Lorsqu’une machine temporaire s’arrête, son interface disparaît. Checkmk peut alors interpréter cette disparition comme un changement d’état à signaler.
Le problème ne venait donc pas d’une panne réseau. Le cycle de vie normal d’une ressource éphémère était traité comme celui d’un port physique.
J’ai commencé par faire découvrir les interfaces Proxmox avec leur description Linux stable plutôt qu’avec un numéro générique du type Interface 12. Cela évite qu’un bridge, un VLAN ou une nouvelle interface récupère le service d’un ancien périphérique.
J’ai ensuite ajouté une règle très ciblée :
| |
Je n’ignore pas « les interfaces de Proxmox ». Je retire uniquement les services qui correspondent au motif des TAP éphémères. Les interfaces physiques, les bridges, les VLANs et les interfaces des machines invitées restent surveillés.
C’est une nuance importante : une bonne exception décrit un comportement attendu, pas une catégorie suffisamment large pour faire disparaître le problème.
Un pic n’est pas encore une panne
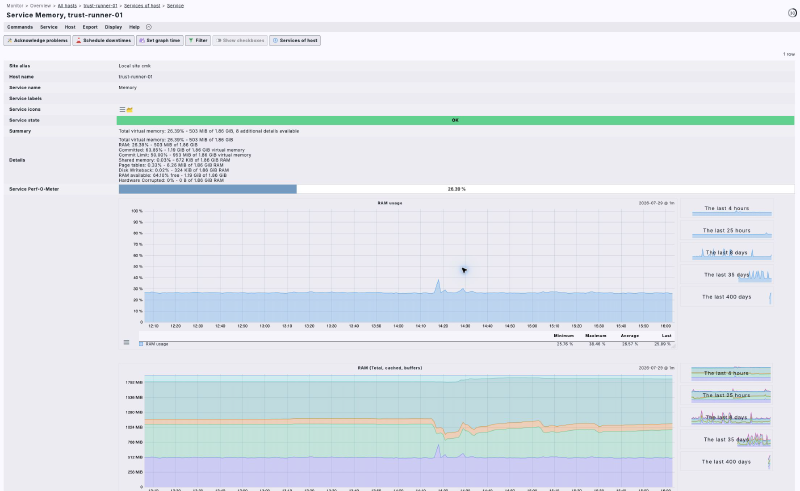
Le runner GitLab présente un autre cas. Pendant un build, sa consommation mémoire peut monter brutalement pendant un cycle de contrôle, puis revenir à la normale.
Ce pic reste intéressant. S’il dure, je veux le savoir. S’il ne concerne qu’une mesure isolée, je ne veux pas être interrompu.
Checkmk distingue justement les états soft et hard. Un premier échec peut rester transitoire ; il ne devient un problème confirmé qu’après le nombre de tentatives défini.
Pour le service Memory de trust-runner-01, j’ai choisi deux contrôles consécutifs :
| |
Un pic d’un cycle reste visible dans l’historique, mais ne déclenche pas de notification immédiate. Si la pression persiste au contrôle suivant, l’état devient hard et l’alerte suit son chemin normal. Avec la fréquence actuelle des contrôles, cela représente environ une minute de confirmation.
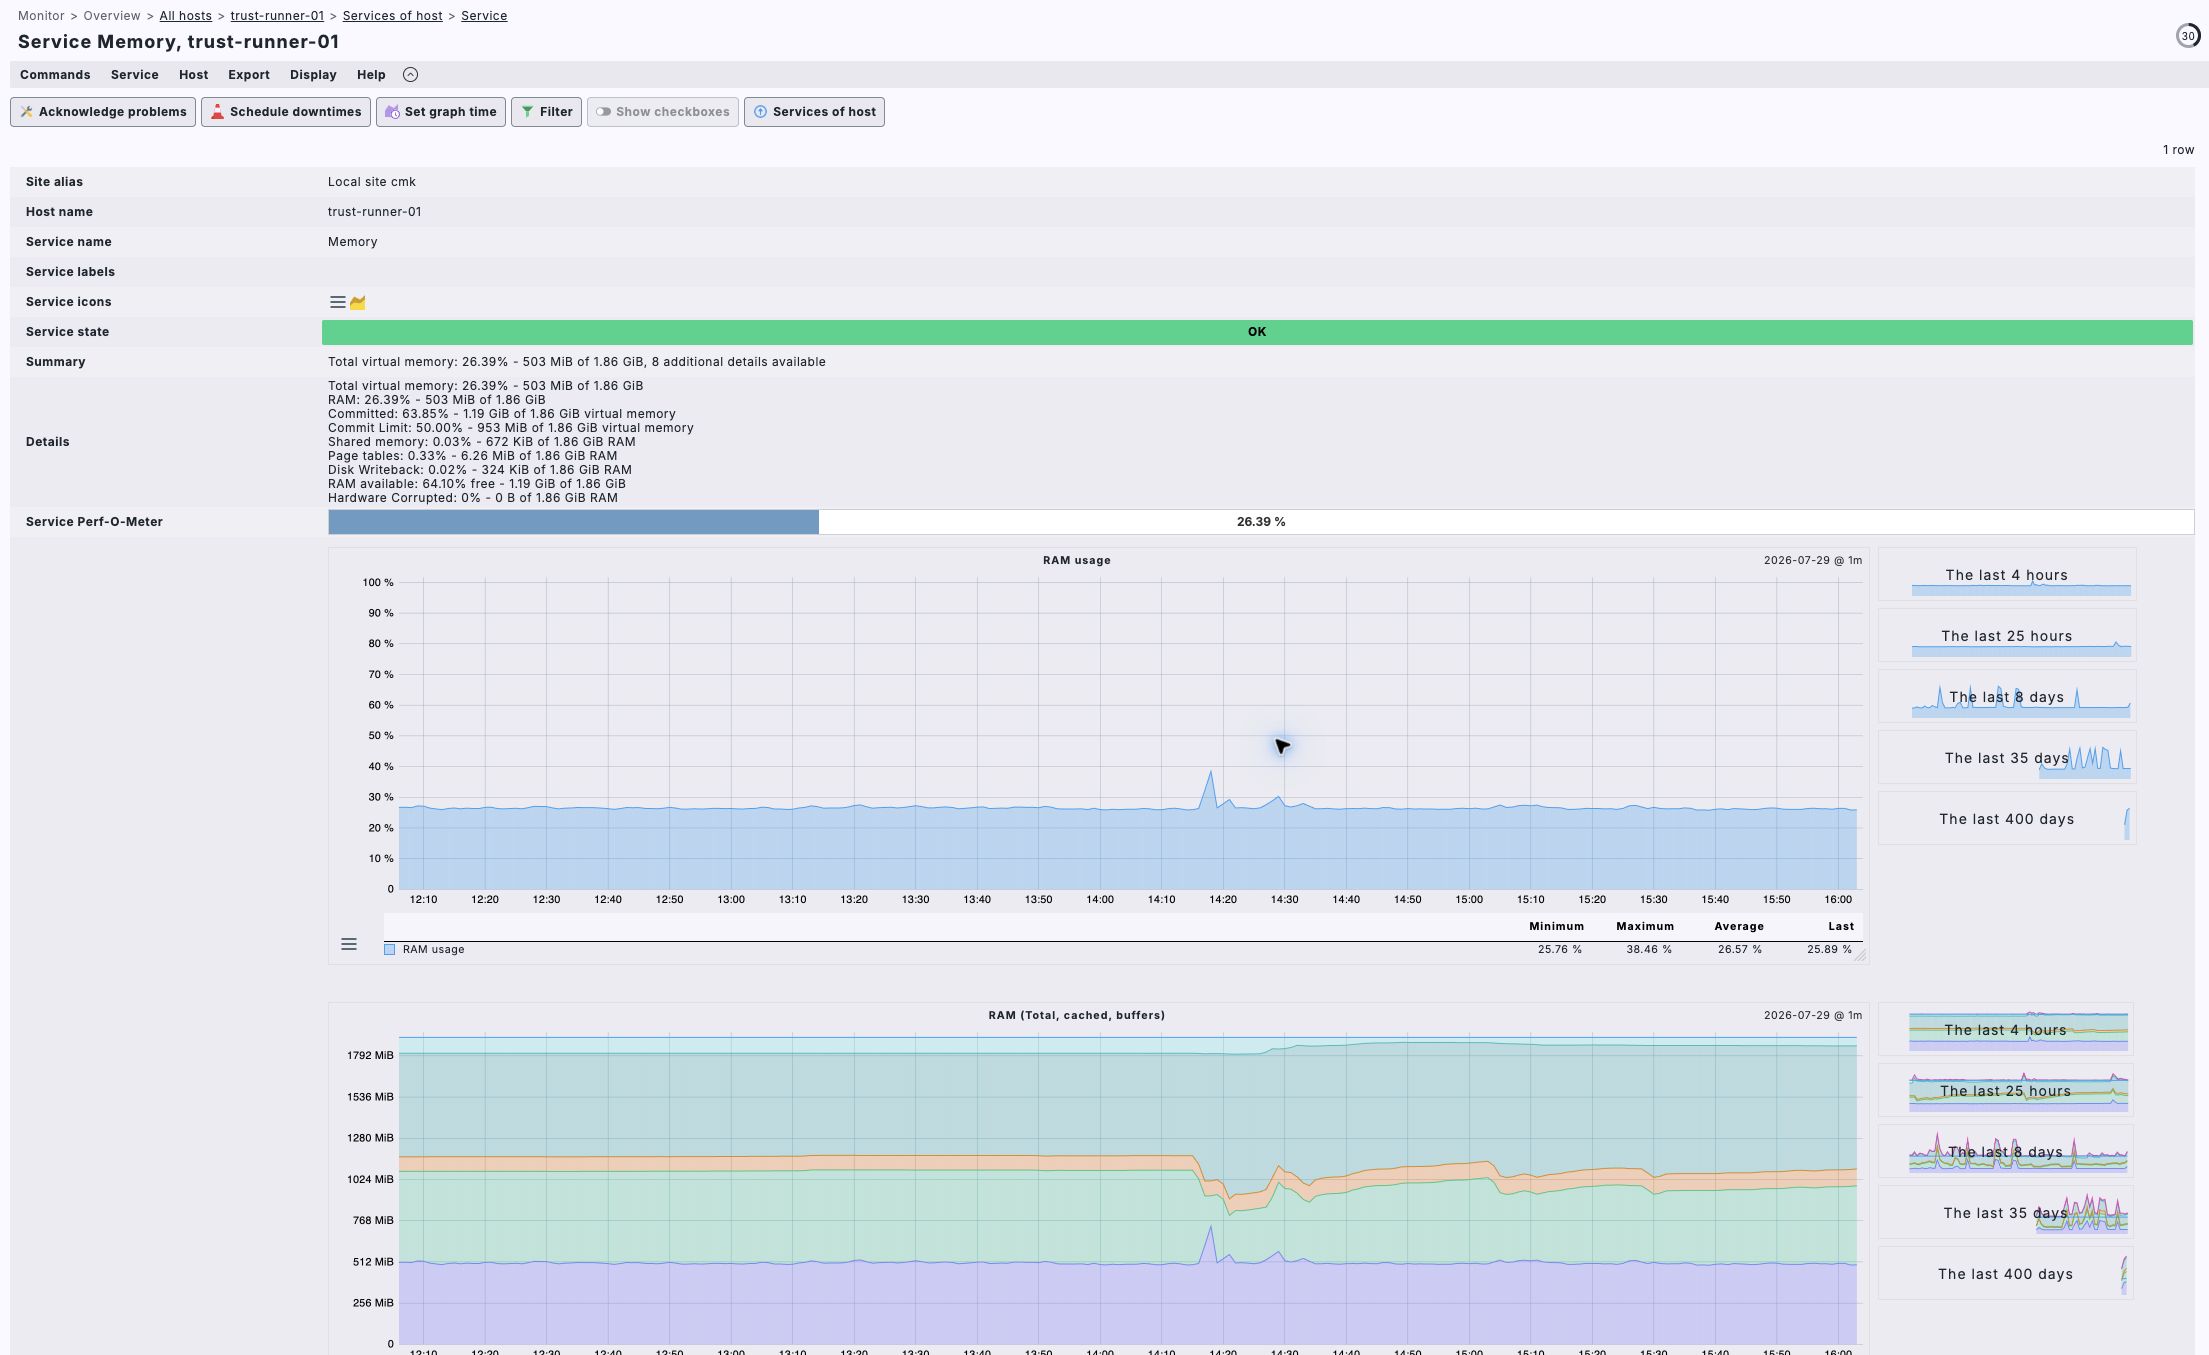
Les pics courts restent visibles dans le graphe sans transformer automatiquement chaque mesure isolée en notification.
J’ai appliqué le même raisonnement aux contrôles SMTP entrant et IMAP de ma plateforme mail. Un timeout isolé mérite une nouvelle tentative ; deux échecs consécutifs commencent à ressembler à un incident.
En revanche, je n’ai pas ajouté un délai arbitraire de plusieurs heures au test de livraison de bout en bout. Cette sonde possède déjà sa propre notion du temps : avertissement après 120 secondes et état critique après 300 secondes. Ajouter quatre heures de silence par-dessus revenait à rendre le contrôle presque inutile.
Espacer une notification sans effacer le problème
Les disques posent une question différente. Un filesystem plein, une erreur SMART ou une latence d’entrée-sortie ne disparaissent pas parce que j’ai déjà reçu l’alerte.
Mais recevoir continuellement le même message ne rend pas la réparation plus rapide.
J’ai conservé les services SMART, Filesystem et Disk IO visibles dans Checkmk avec leurs états normaux. C’est uniquement la fréquence de leurs notifications sortantes qui est limitée :
| |
Le mécanisme garde une réservation par couple hôte/service. Une première notification de problème passe, puis les répétitions sont bloquées pendant 24 heures glissantes. Si le problème reste actif, Checkmk envoie un rappel quotidien.
Les retours à l’état normal restent présents dans l’historique Checkmk, mais ne génèrent pas de nouvelle notification pour ces trois familles de services. Je préfère ouvrir l’interface et retrouver toute la chronologie plutôt que d’être interrompu à chaque oscillation autour d’un seuil disque.
Il y a un détail auquel je tenais : si l’envoi de la notification échoue, la réservation est libérée. Le système pourra donc retenter plus tard au lieu de considérer comme livré un message qui n’est jamais arrivé.
Enfin, cette limitation ne concerne ni les hôtes, ni les autres services. Une machine inaccessible ou un contrôle métier en échec ne profite pas discrètement du même silence.
Un seuil doit représenter un risque
La supervision DNS de Technitium m’a fourni un bon exemple de seuil techniquement valide, mais opérationnellement trop sensible.
Je contrôle deux choses depuis le serveur Checkmk :
- une résolution DNS autoritative en UDP, avec vérification de la réponse ;
- l’ouverture du transport DNS sur le port TCP 53.
Au départ, les deux contrôles avertissaient au-dessus de 500 millisecondes. J’ai conservé ce seuil pour l’ouverture TCP, mais porté l’avertissement UDP à une seconde. L’état critique reste fixé à 1,5 seconde et le timeout à trois secondes.
Pourquoi séparer les deux ? Une connexion TCP sur le réseau interne doit rester très rapide. Une requête DNS complète traverse davantage d’étapes et peut subir une variation ponctuelle sans que le service soit dégradé.
Le 29 juillet 2026, ma vérification en lecture seule remontait :
| Service | État observé | Temps de réponse |
|---|---|---|
| résolution DNS Technitium en UDP | OK | 65 ms |
| transport DNS Technitium en TCP | OK | 7 ms |
Ce sont des mesures prises à un instant donné, pas une promesse de performance. Elles confirment surtout que les contrôles interrogent réellement le service et exposent leur métrique après la modification.
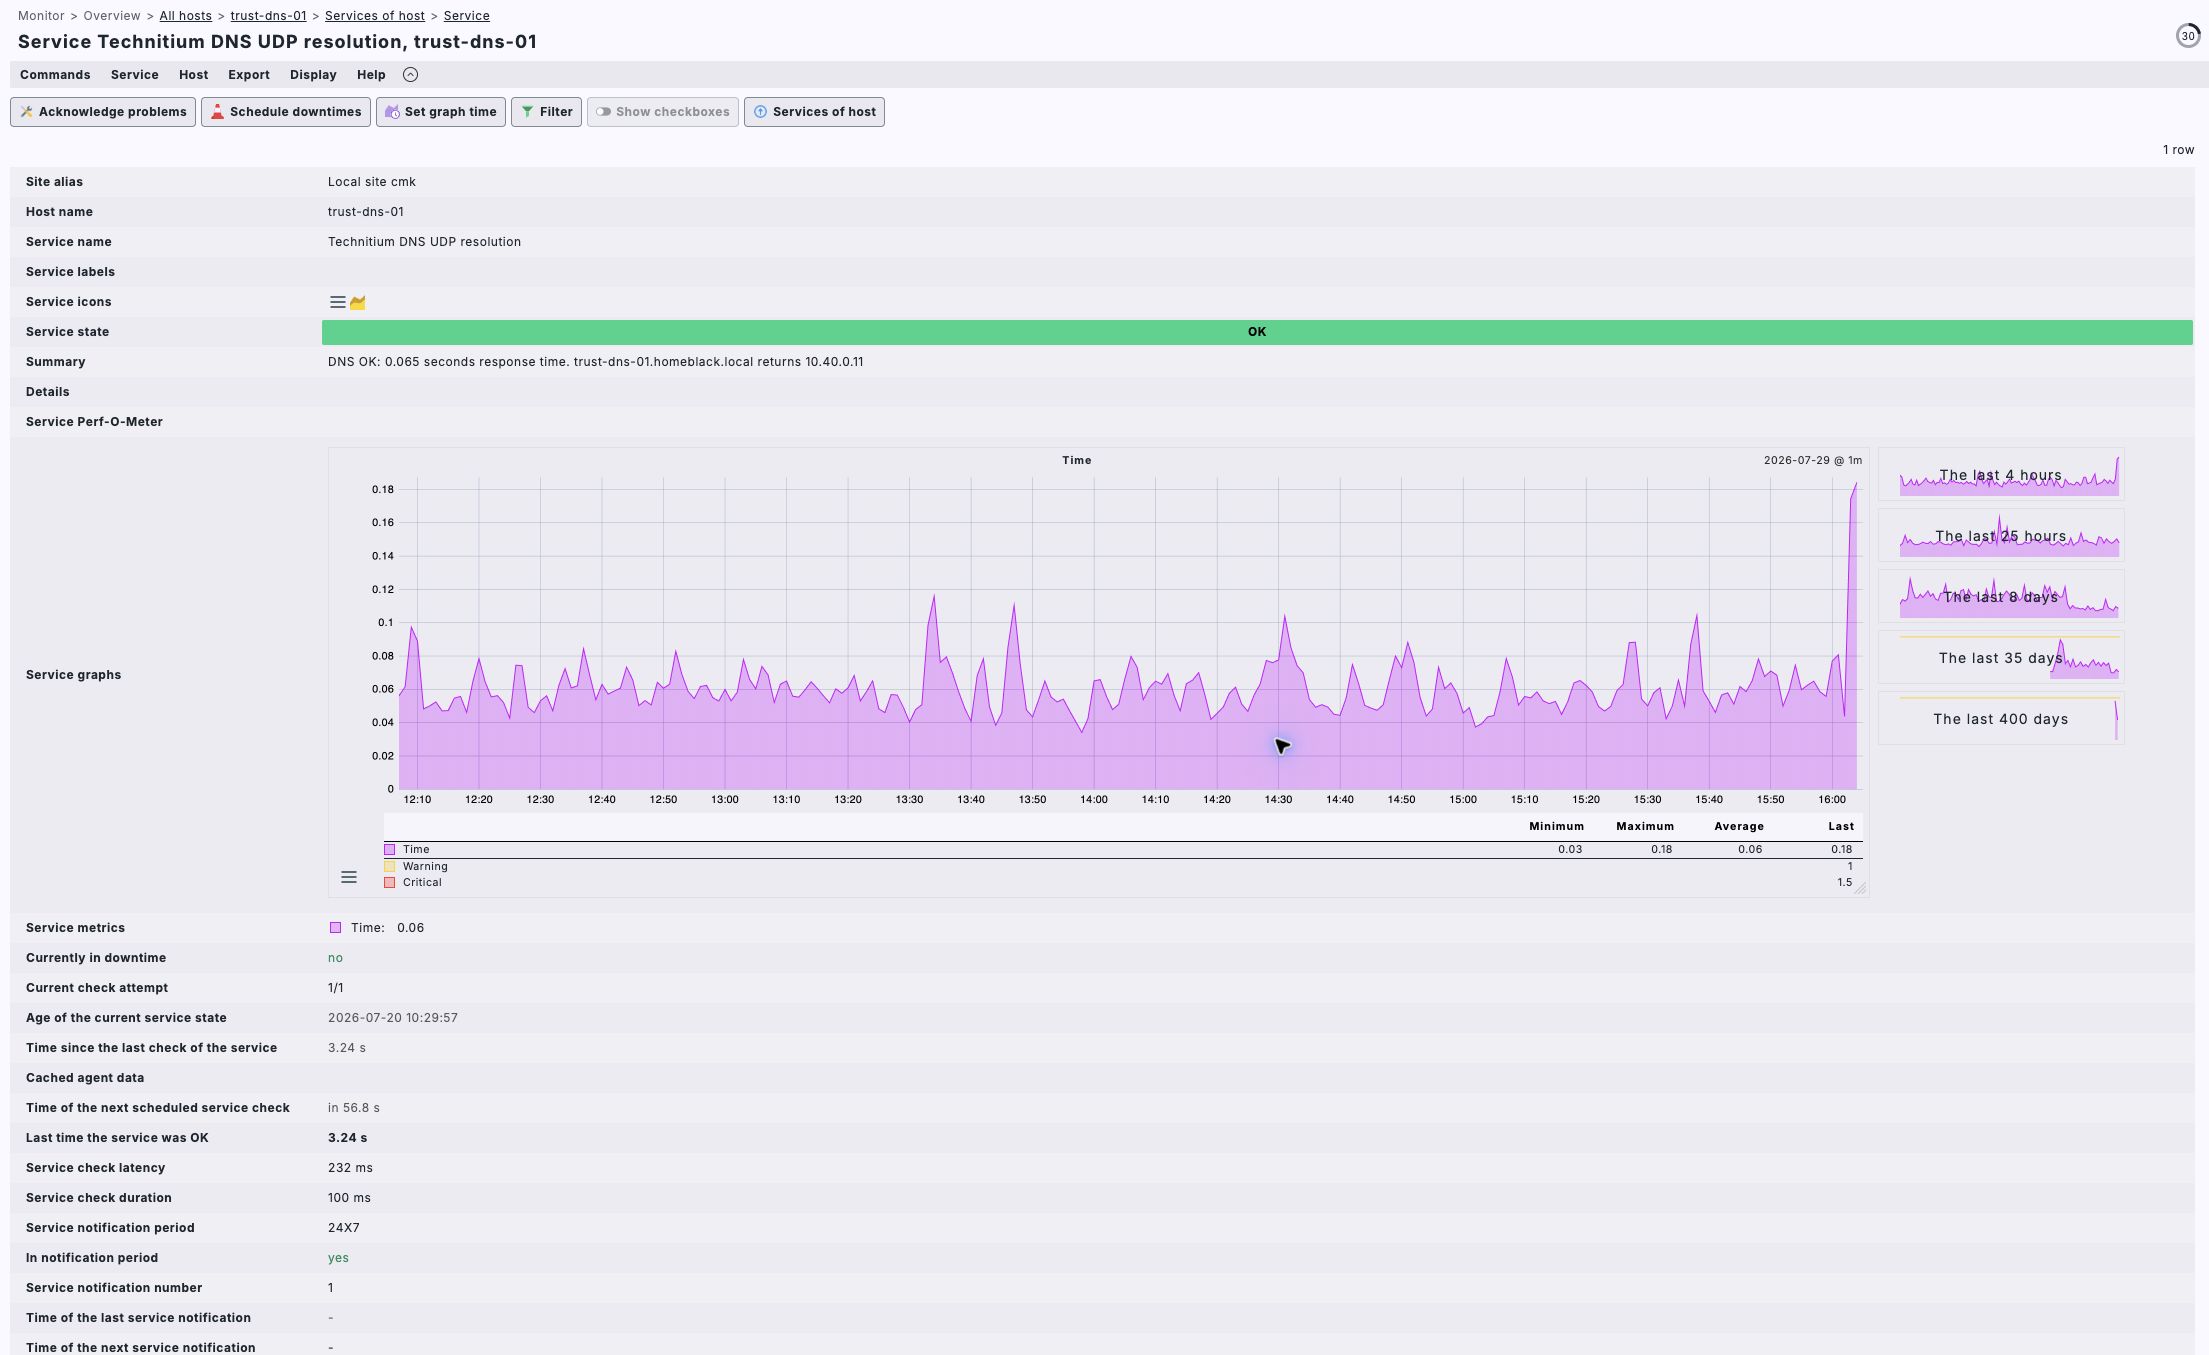
La mesure UDP reste très en dessous du seuil d’avertissement fixé à une seconde ; le seuil critique apparaît à 1,5 seconde.
Ce que je refuse de faire taire
Réduire le bruit n’a d’intérêt que si les vrais problèmes restent bruyants.
Les avertissements critiques NVMe et les erreurs d’intégrité continuent donc d’alerter dès leur première occurrence. Les filesystems restent surveillés avec leurs seuils normaux. Lorsque le disque du runner manque réellement de place, la réponse attendue est un nettoyage ou une augmentation du volume, pas un seuil plus généreux.
Même logique pour les TAP : j’ignore les interfaces éphémères, mais pas les uplinks. Pour la mémoire du runner, j’ajoute une confirmation, mais je ne supprime pas le contrôle. Pour le DNS, je détends seulement le seuil UDP ; le contrôle TCP conserve sa valeur plus stricte.
Je me sers désormais de cette règle simple :
Si l’alerte représente un problème mesuré, je la garde. Si elle décrit un comportement attendu, je corrige son modèle.
Des règles versionnées plutôt que des clics oubliés
Tous ces réglages sont décrits dans le dépôt d’infrastructure et appliqués par un helper qui utilise l’API REST de Checkmk. Cela me permet de relire une exception, de comprendre pourquoi elle existe et de la tester comme le reste du code.
Pour appliquer les règles de calibration :
| |
Je rejoue ensuite la commande sans activation :
| |
La seconde exécution doit annoncer toutes les règles gérées comme inchangées. Pour les modifications de découverte, notamment les interfaces Proxmox, je relance aussi explicitement la découverte des services concernés :
| |
Les tests automatisés vérifient également la portée des règles : motif exact des TAP, deux tentatives pour la mémoire du runner et intervalle de 1 440 minutes pour les problèmes disque persistants.
Enfin, je contrôle l’état effectif avec Livestatus, directement sur le serveur Checkmk. Lors de la dernière vérification, le service Memory du runner était bien configuré avec deux tentatives maximales. Les deux boucles mail et les contrôles DNS étaient en état OK.
Cette dernière étape est indispensable. Une configuration correcte dans Git ne prouve pas encore que Checkmk l’a activée ni qu’elle s’applique au bon service.
Ce que je retiens
Je pensais au départ qu’une bonne supervision devait tout remonter le plus vite possible. Je la vois maintenant comme un système de décisions : que faut-il conserver dans l’historique, que faut-il confirmer et qu’est-ce qui mérite réellement une interruption ?
Les quatre leviers ne sont pas interchangeables :
- ignorer précisément une ressource éphémère ;
- confirmer un état transitoire avec une nouvelle tentative ;
- espacer le rappel d’un problème déjà connu ;
- adapter un seuil à la mesure réellement effectuée.
Je garde volontairement le canal de réception en dehors de cet article. Je raconterai prochainement comment j’achemine ces alertes, où je les reçois et comment je décide lesquelles ont réellement le droit de m’interrompre.
Depuis cette reprise, l’écran vert m’intéresse moins. Ce qui compte, c’est que la prochaine notification inhabituelle récupère immédiatement mon attention — et qu’elle la mérite.